AI 扫盲第一章:用大白话讲清大模型从输入到输出发生了什么
你问它帮忙写个自我介绍,它 2 秒内给一段流畅文字——中间到底发生了什么?本文用流程图加大白话,把大模型从输入到输出的全过程讲明白,零基础也能看懂。
你在聊天框里打一句"帮我写个简短的自我介绍",敲下回车,不到 2 秒钟一段流畅文字就一个字一个字地冒出来——很多人下意识觉得是模型"看懂了"再"想"出答案。其实没这么玄。这篇我们用大白话把整个过程拆成 6 步,不管是 GPT、Claude 还是 Gemini,内部走的都是同一条路。
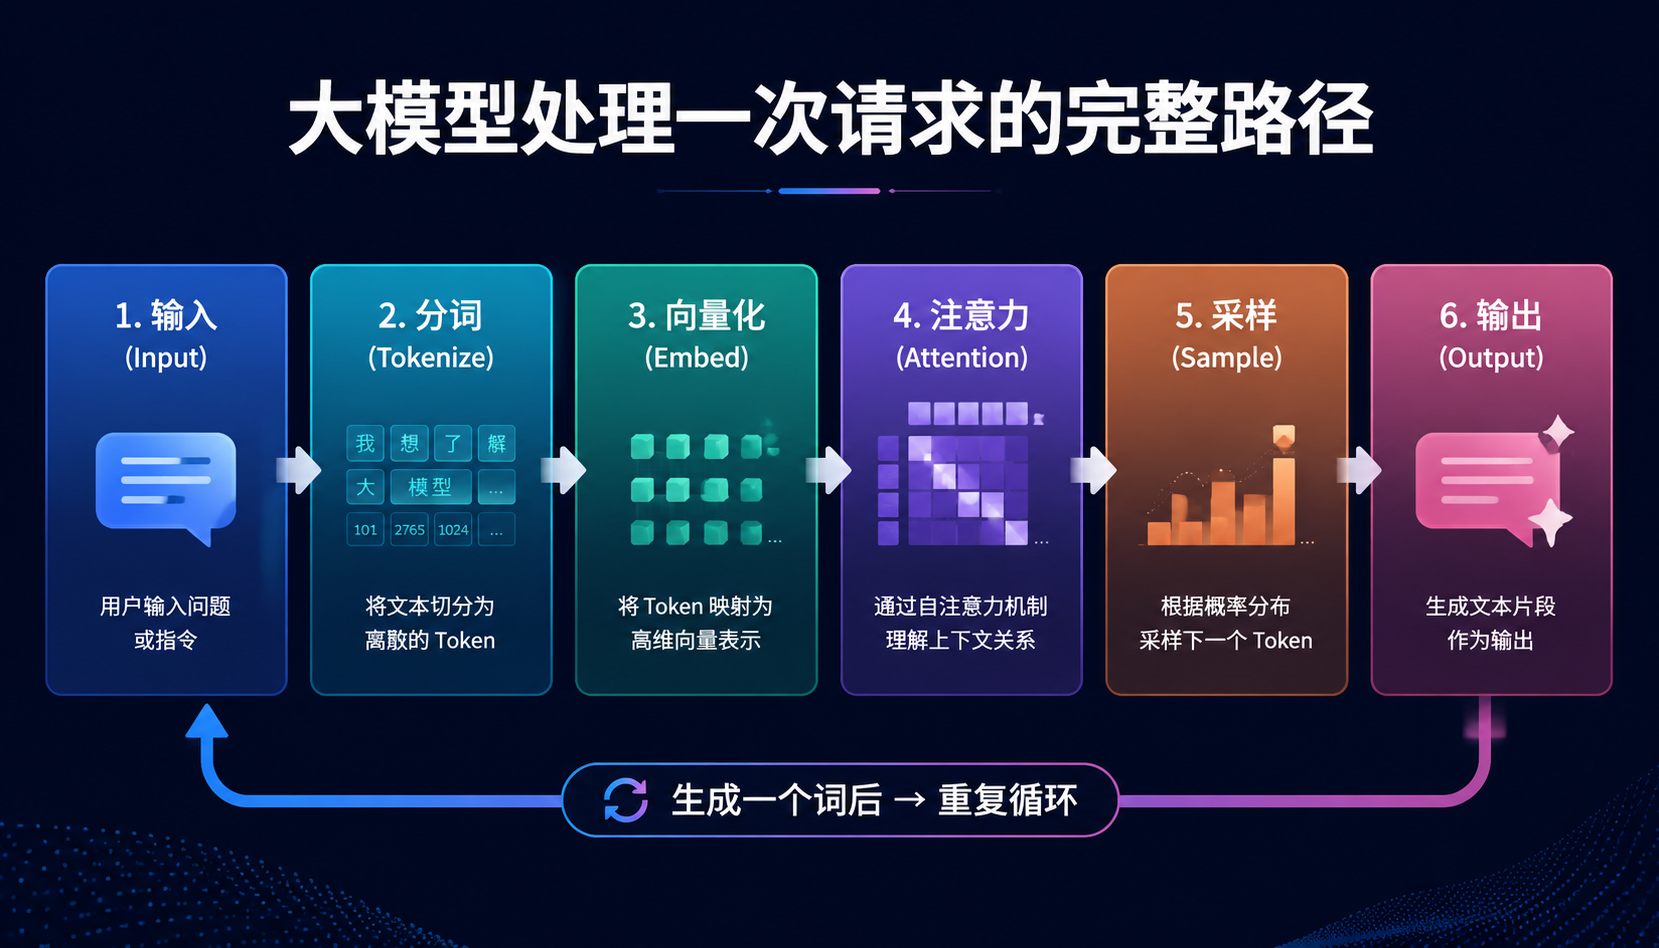
图1 · 大模型处理一次请求的完整路径:输入→分词→向量化→注意力→采样→输出,生成一词后循环
第 1 步你输入的那句话
一切从你敲进聊天框的文字开始。这是模型看到的"原材料"——一个问题、一段代码、一份文档都行,对它来说都一样,都是一段待处理的字符。但模型本身并不认识汉字、也不认识英文,它只认识数字。所以它要做的第一件事,就是把你的话翻译成它能处理的形式。
第 2 步把文字切成"小积木"(Token)
模型会把你的话切成一块一块的小片段,每一块叫做一个 token。每一块都对应一个固定编号,于是一段话就被翻译成了一串数字。
这里有个很多人不知道的计费细节:API 都是按 token 计费的,不是按字符。中英文同样信息量,中文消耗通常是英文的 2–3 倍,看下面这张表:
* 实际比值受词表版本影响,但中英 2–3× 差距是稳定现象。
第 3 步给每块积木一个"坐标"(向量)
光有编号不够,模型得知道这些积木之间的关系:哪些意思相近、哪些不相干。所以它给每块积木分配一个坐标——不是二维三维,是几千维的那种高维坐标。
意思相近的词坐标挨得近:"猫"和"狗"在这个空间里是邻居,和"土豆"就隔得远。几千维你不用真去想象,只要记住一件事:所谓"模型理解了你的意思",本质上是把词变成坐标、然后在高维空间里做几何运算。没有神秘的"意会",全是数学。
第 4 步词和词互相"打招呼"(注意力机制)
这是大模型的核心,专业名词叫"注意力机制"(Attention)。说人话就是:每块积木会环顾一下四周,看看哪些邻居对理解自己最有用,再把这些邻居的信息汇总过来。
这个动作不是只做一次。模型会层层叠叠做几十遍,每一遍都在更高层次上重新"看一遍"整段输入。这就是为什么它能抓住伏笔、理解指代、顺着长文章一路推理下去。
第 5 步算出"下一个字最可能是什么"
前面几步做完,模型已经把你的输入"消化"完了。接下来它做的事非常简单:猜下一个字是什么。具体做法是给词表里每一个候选词打一个分数,分数越高代表这个词越可能是下一个。比如输入是"今天天气真":
今天天气真 → 模型给候选词打分:模型实际的"思考结果"就是这么一张概率表,没有语义,只有数字。
第 6 步从概率表里抽一个词(采样)
到这里有一件反直觉的事:模型不是每次都选分数最高的那个词,而是按概率随机抽签。抽签的激进程度由一个叫 temperature 的参数控制。
这也解释了两件常见的事:同一个问题问两次,答案不完全一样——因为每一步都在抽签。做代码生成、数据抽取时,老手会把 temperature 调到 0 附近,就是为了把这种随机性压下去。
最关键一步:吐一个字、拼回去、再走一遍
最容易被忽略的事:模型不是一次性想好整段回答再输出的。它每次只挑出一个字(严格说是一个 token),吐出来,然后把这个吐出来的字拼回原输入,组成一段更长的新输入,再从头走一遍第 2 到第 6 步,挑下一个字……一直循环,直到它算出该停下(吐出一个"结束"标记)。
顺便回答 3 个新手最常问的问题
新手 5 条记不住就会吃亏的事
- 1中文 prompt 比英文贵 2–3 倍,能英文就英文,账单立省一半。
- 2严肃任务把 temperature 调低(接近 0),不是越高越聪明,写代码、抽数据时尤其重要。
- 3长对话超过窗口会失忆,重要信息要不停复述,或者写进系统提示里。
- 4幻觉不能靠多问几遍消除,具体人名、条款、数字一定要外部检索或人工核对。
- 5生成慢是正常的,它真的在一个字一个字挤,不是网络卡。
把最底层讲完了,下一篇开始讲每个模型的"性格差异"——哪款写代码快、哪款写长文稳、哪款能画图识图。想追着看,收藏本站即可。
查看新人订阅方案 →